OpenClaw na prática, parte 1: instalação no WSL e por que não usei modelo local numa GPU de 4 GB

Série OpenClaw na prática, parte 1: configurando o OpenClaw como agente de código com LLMs gratuitos num SaaS em produção. Dados de outubro de 2026.
TL;DR: Para ter um agente de código a custo zero, instalei o OpenClaw no WSL com Node 24 via nvm. Com ~9,6 mil tokens de prompt fixo por chamada e 32K de contexto, uma GPU de 4 GB não serve: nenhum modelo local.
Sobre esta série
Esta é a parte 1 da série OpenClaw na prática, sobre como configurei o OpenClaw no WSL como agente de código usando só LLMs gratuitos, num SaaS real (o Acme). No dia a dia do projeto, uso o Cursor como editor e o Grok Bot como agente de IA; o OpenClaw entrou como agente de código local a custo zero.
- Parte 1 (esta): contexto, limpeza, instalação e hardware
- Parte 2: por que os free tiers acabam e a comparação de provedores
- Parte 3: o que deu errado e como testar modelos com curl
- Parte 4: a escolha dos modelos, um por um
- Parte 5: cadeia com failover, configuração, chaves e dashboard
- Parte 6: contexto do projeto, segurança, conclusão e checklist

O contexto: um SaaS, um monorepo e zero orçamento para IA
Estou construindo o Acme (nome fictício), um SaaS que vive num monorepo com três partes principais:
- uma API em Express;
- um site em Next.js;
- um painel admin em Next.js.
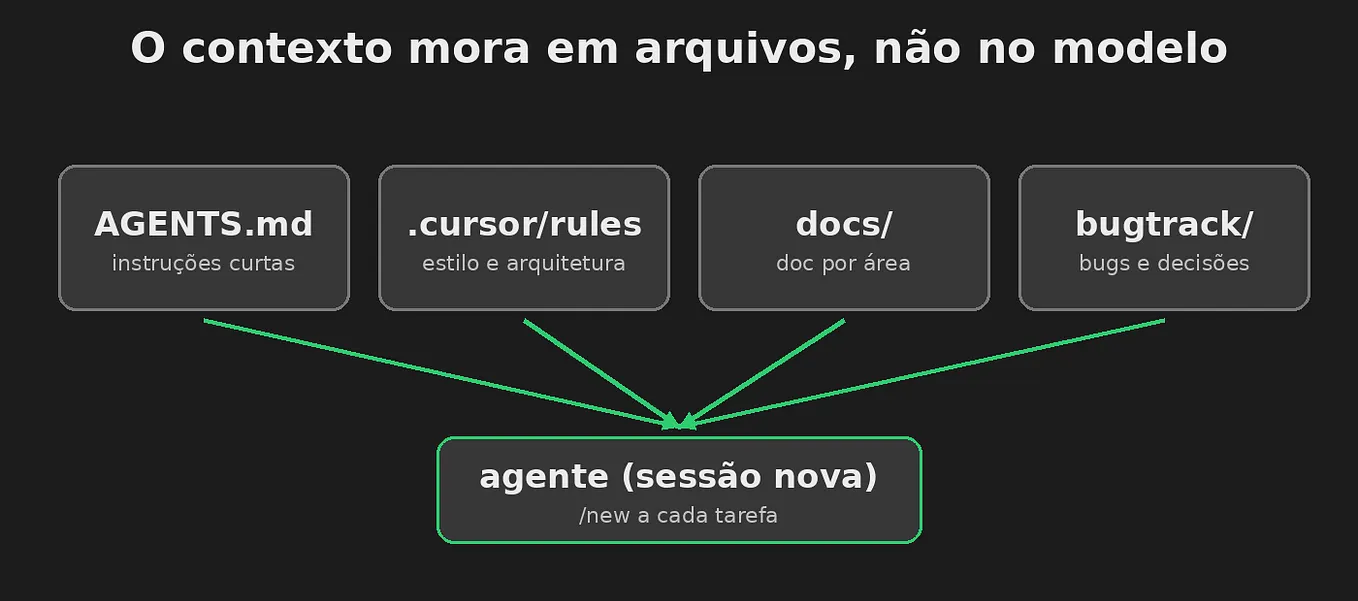
O repositório também tem bastante material para humanos e máquinas: uma pasta docs/, um AGENTS.md na raiz, regras em .cursor/rules e uma pasta de bugtrack onde registro bugs e decisões.
No dia a dia do projeto, uso o Cursor como editor e o Grok Bot como agente de IA. Para esta etapa, eu queria também um agente de código rodando localmente, que lesse o projeto, propusesse mudanças, executasse comandos e me ajudasse. Escolhi o OpenClaw. A restrição era clara: custo zero, pelo menos nesta fase.
Minha primeira tentativa foi com o free tier da API do Gemini, e ele durou umas três tarefas. Depois disso, só erro 429 e mensagens de cota estourada. Foi aí que entendi que precisava fazer as contas antes de sair configurando.
Esta parte da série conta o que fiz, o que errei e o que ficou de pé no fim.
Passo 1: limpando a instalação antiga
Eu já tinha uma instalação antiga do OpenClaw no Windows, com o app de bandeja “OpenClaw Companion”. Como ia recomeçar do zero dentro do WSL, decidi remover tudo para evitar conflito de portas e de configuração.
O que fiz:
- Backup primeiro. Copiei as configurações antigas (a pasta de config do usuário) para um lugar seguro. Mesmo sem intenção de reaproveitar, é bom ter onde consultar o que estava configurado.
- Desinstalei o OpenClaw Companion pelo “Aplicativos instalados” do Windows.
- Conferi se não sobrou nenhum processo na bandeja nem serviço escutando na porta do gateway.
💡 Dica: se você vai migrar de Windows nativo para WSL, não deixe as duas instalações vivas ao mesmo tempo. As duas tentam usar a mesma porta e você vai perder tempo achando que o problema está em outro lugar.
Passo 2: instalando o OpenClaw do zero no WSL (Ubuntu)
Por que dentro do WSL?
Agentes de código executam muitos comandos de shell, como git, npm e grep, e o ecossistema todo é mais previsível em Linux. Além disso, o gateway do OpenClaw roda bem como serviço systemd de usuário dentro do WSL. A documentação tem uma página específica para Windows e outra de instalação.
Node 24 via nvm (sem sudo)
O OpenClaw exige Node ≥ 24.16. Um detalhe que pega muita gente: o Node instalado no Windows não serve dentro do WSL. Mesmo que node apareça no PATH (o WSL herda o PATH do Windows), é o binário errado. Instale um Node nativo do Linux.
Get Neto Orlando’s stories in your inbox
Join Medium for free to get updates from this writer.
Usei o nvm, que instala tudo no seu home e não precisa de sudo:
# Instala o nvm (confira a versão mais recente no repositório oficial do nvm)
curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.40.3/install.sh | bash

# Recarrega o shell (o instalador adiciona o nvm ao ~/.bashrc)
source ~/.bashrc

# Instala e ativa o Node 24
nvm install 24
nvm alias default 24

# Confere: precisa ser >= 24.16 e o caminho precisa estar dentro do seu home Linux
node -v
which node   # deve mostrar algo como ~/.nvm/versions/node/v24.x.x/bin/node
Se which node mostrar algo em /mnt/c/..., o WSL está pegando o Node do Windows. Corrija o PATH antes de seguir.
Instalando o OpenClaw
curl -fsSL https://openclaw.ai/install.sh | bash -s -- --no-onboard --no-promptAs flags fazem diferença:
--no-onboard: pula o assistente inicial. Prefiro configurar os provedores depois que eu souber quais vou usar.--no-prompt: instalação não interativa.
⚠️ Rodar
curl | bashé sempre um ato de confiança. Se preferir, baixe o script, leia e só depois execute.

Passo 3: análise de hardware (“como um engenheiro do Google faria”)
Antes de escolher modelos, sentei e fiz o que deveria ter feito desde o começo: olhar a máquina e os números, sem achismo.
A máquina
- CPU: Intel i5–9400F, 6 núcleos / 6 threads, sem hyper-threading, sem GPU integrada.
- RAM: 16 GB. O WSL, sem
.wslconfig, ficou com ~7,7 GiB. Por padrão, o WSL2 usa cerca de metade da RAM (docs do.wslconfig). - GPU: GTX 1650, 4 GB de VRAM, visível dentro do WSL (
nvidia-smifunciona).
O que o OpenClaw exige de um modelo
Medindo as chamadas, cheguei a estes números:
- ~9,6 mil tokens de system prompt + schemas de ferramentas em toda chamada, antes mesmo de você digitar qualquer coisa;
- contexto de trabalho de 32K tokens.
A página de Context da documentação explica o que entra nessa conta: system prompt, histórico da conversa, resultados de ferramentas e os arquivos do workspace injetados. O comando /context mostra o detalhamento na sua própria sessão.
O que isso significa para modelos locais
Com 4 GB de VRAM, o realista é um modelo de até ~4B parâmetros quantizado. Na prática:
- Prefill lento: processar 10K+ tokens de prompt a cada chamada numa GTX 1650, ou pior, com parte do modelo na CPU, leva muito tempo. E isso se repete a cada passo do agente.
- Contexto de 32K exige memória para o KV cache, que disputa espaço com os pesos do modelo nos mesmos 4 GB.
- Qualidade: modelos pequenos até completam código, mas erram em tarefas de vários passos com ferramentas. Eles chamam a ferramenta errada, esquecem o objetivo, entram em loop ou geram JSON de tool call malformado.
A própria página de Local models do OpenClaw recomenda a maior build disponível do modelo (“evite variantes small ou muito quantizadas”). Ela cita receitas com contexto de 64K e um piso de 8 GiB de memória só para a menor delas, e ainda alerta para um crash loop conhecido com WSL2 + Ollama + CUDA. Minha máquina está abaixo de tudo isso.
Decisão
Nenhum modelo local. Nem como fallback. Para agentes de código nesse hardware, o custo em tempo e frustração não compensa. Modelo local ainda faz sentido para autocomplete ou perguntas rápidas, mas não para um agente que precisa navegar num monorepo.
Conclusão
Antes de escolher modelo, olhe a máquina e os números. No meu hardware, agente local não compensava, e aceitar isso cedo economizou dias.
Na parte 2: por que os free tiers acabam em poucas tarefas e a comparação de provedores gratuitos de outubro de 2026. Ficou com alguma dúvida ou fez diferente? Conta nos comentários.